Исследователи Лоренцо Перини, Миа Гаррард, Рина Фридберг, Рохит Кумар, Хуссам Нассиф, Аббас Заиди и Пабло Алькаин из компании Meta Platforms опубликовали в репозитории препринтов arXiv алгоритм, который позволяет безопасно останавливать онлайн-эксперименты раньше намеченного срока. Новый метод снизил среднюю продолжительность тестирования с двух недель до восьми дней и увеличил пропускную способность экспериментальной платформы на 76 процентов без потери математической строгости.
Почему нельзя просто подглядывать в результаты
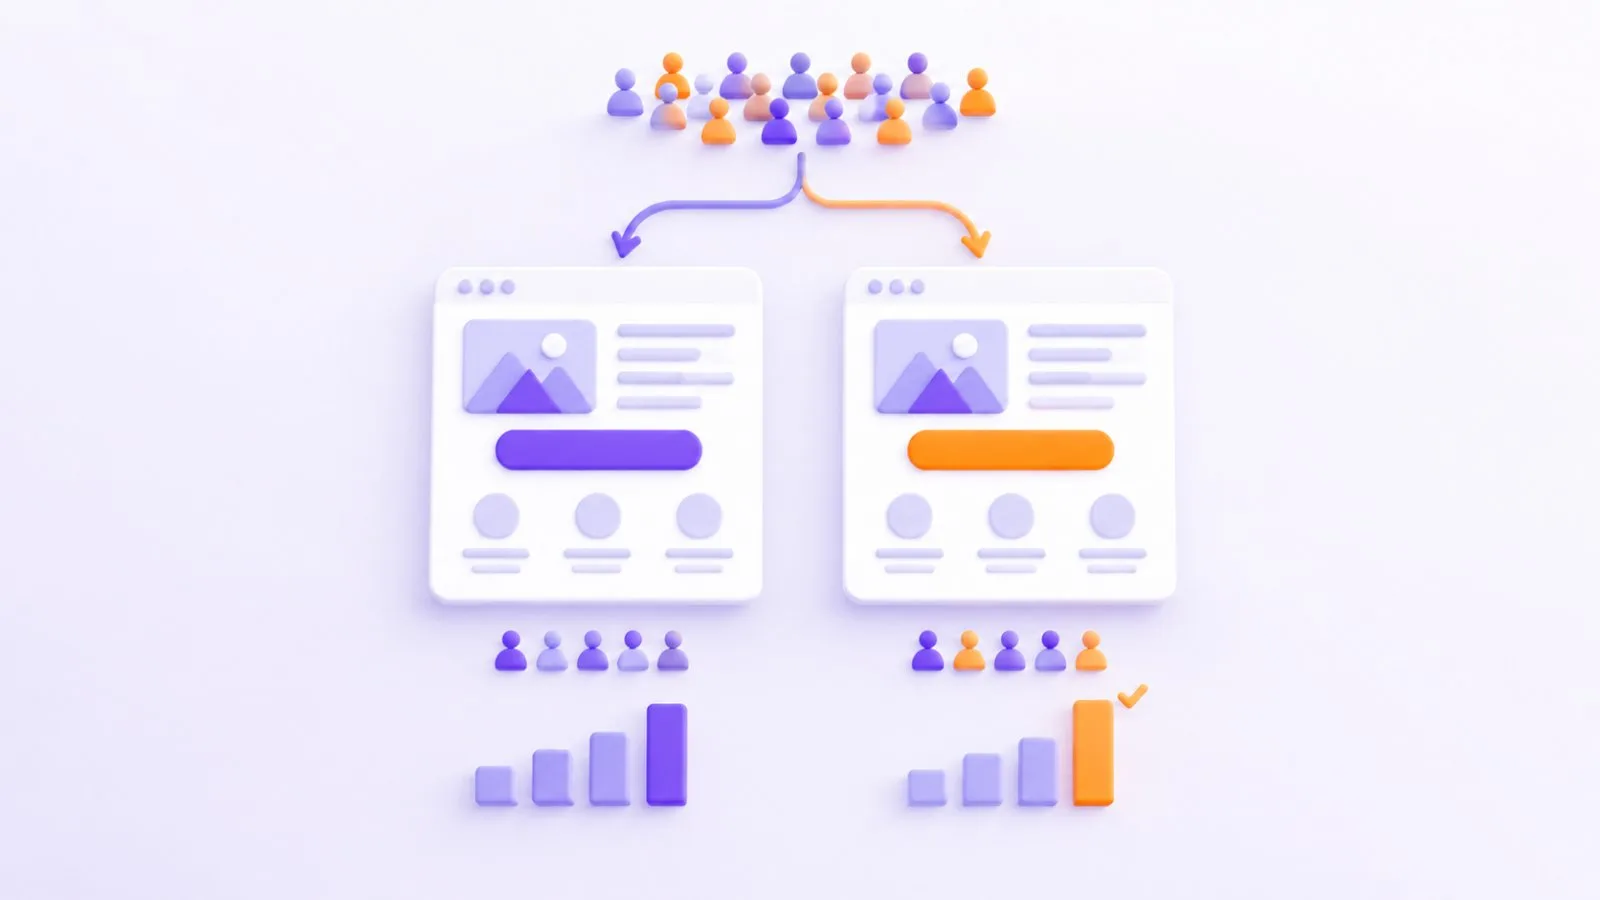
A/B-тестирование служит главным инструментом проверки продуктовых гипотез в ИТ-компаниях. Пользователей делят на две группы: одной показывают привычную версию сервиса, а второй — вариант с новым алгоритмом или изменённым дизайном. Обычно такой эксперимент запускают на строго фиксированный срок, например на 14 дней. В конце инженеры сравнивают накопившуюся разницу показателей с порогом надёжности и решают, запускать ли новинку на всю аудиторию.
Разработчикам трудно ждать две недели, если обновление с первых дней показывает явный провал или стремительный рост. Команды начинают проверять промежуточные графики каждый день и останавливать тесты на волне первого впечатления. В статистике такую привычку называют подглядыванием. По данным профильных отчётов аналитиков и инженеров сервиса Spotify, постоянный мониторинг промежуточных результатов раздувает долю ложноположительных ошибок с нормальных пяти процентов до почти сорока. Случайные колебания активности в удачный день легко принять за устойчивый успех новой функции.
Существующие методы непрерывной проверки были созданы для работы без ограничения по времени. При строгом двухнедельном дедлайне они становятся неоправданно осторожными и резервируют запас точности под бесконечность, которая в реальной жизни никогда не наступает. Другой классический инструмент — ступенчатый групповой анализ — сдвигает порог принятия решений в последний день эксперимента. Продуктовые команды не любят такие перемены: инженерам приходится заново привыкать к плавающим критериям оценки на финише.
Коридор решений и память о пользователях
Авторы исследования построили алгоритм вокруг предиктивной вероятности успеха. Математическая модель в каждый день эксперимента оценивает шанс того, что к финальному сроку показатель превысит установленный порог. На основе этой вероятности система рассчитывает две границы: верхнюю и нижнюю.
Если значение пробивает верхнюю границу, результат считают доказанным успехом и новинку сразу отправляют на раскатку. Если метрика падает ниже нижней границы, идея признаётся бесперспективной и показ обновления прекращают. Пока данные держатся внутри коридора, сбор наблюдений продолжается. В последний день теста предиктивная вероятность превращается в стандартный платформенный критерий. Если эксперимент дошёл до финиша, инженеры оценивают его ровно по тем правилам, к которым привыкли за годы работы.
Главной математической сложностью стало поведение пользователей. В интернет-сервисах одни и те же люди заходят в приложение каждый день, поэтому ежедневные порции данных связаны между собой. В теории вероятностей это называют автокорреляцией. Повторный визит одного постоянного читателя сообщает меньше свежих сведений, чем появление нового человека. Если считать наблюдения независимыми, формула занизит реальную погрешность и пропустит ошибку. Исследователи из Meta оценили силу этой дневной связи по историческим контрольным тестам, где обе группы пользователей видели одинаковый интерфейс. На основе полученной матрицы корреляций авторы вывели формулу эффективного объёма выборки, которая корректирует ширину коридора решений с учётом повторных заходов.
Восемь дней вместо двух недель
Исследователи начали проверку алгоритма с массива из 100 тысяч синтетических траекторий. В симуляции новый метод достиг теоретического предела скорости и сократил среднюю длительность эксперимента до 8,16 дня при оптимальном плановом горизонте в 17 дней. Если принудительно ограничить максимальный срок стандартными двумя неделями, средняя длительность составляет 9,17 дня. Метод превзошёл классические схемы последовательного анализа О’Брайена–Флеминга и Покока, которым требовалось больше времени на принятие решения.
После симуляции алгоритм протестировали примерно на двух тысячах реальных онлайн-экспериментов платформы Meta. Все тесты отслеживали внутренний показатель предложения сервиса. На реальных данных среднее время проверки гипотезы составило 7,97 дня при доверительном интервале от 7,81 до 8,15 дня. Эксперименты стали короче на 43,1 процента. Поскольку завершённые тесты сразу освобождали слоты для следующих задач, полезная ёмкость платформы выросла на 76 процентов. При этом частота ложных срабатываний не превысила плановые десять процентов, а тест стабильно замечал реальные улучшения минимум в восьмидесяти случаях из ста.
Человеческий фактор и плата за ранний финиш
Математические гарантии работают только при одном условии: решение об остановке принимается сразу, как только график пересёк границу. В реальности инженеры часто сомневаются и продолжают держать включённым неудачный эксперимент, надеясь на выравнивание ситуации или проверяя страховочные метрики. Нарушение правила разрушает контроль над ошибками, а задержка с запуском успешной версии уничтожает выигранное время. Чтобы исключить сомнения людей, авторы предложили поручить закрытие тестов автономным программным агентам, хотя в самой работе таких агентов на практике не запускали.
Досрочная остановка влечёт за собой и статистическое искажение, известное как проклятие победителя. Если завершить тест на пике случайного всплеска, зафиксированный прирост окажется завышенным. Чтобы узнать настоящую величину эффекта, оценку после остановки нужно корректировать отдельными формулами сглаживания. Кроме того, за сохранение привычного финального порога приходится платить: если эксперимент не показал явного перевеса и дошёл до конца, максимальный срок проверки вырастает с 14 до 17 дней. Наконец, исследование охватило только одну внутреннюю метрику сервиса, не затрагивало показатели выручки с редкими всплесками, а исходный программный код алгоритма авторы не опубликовали.