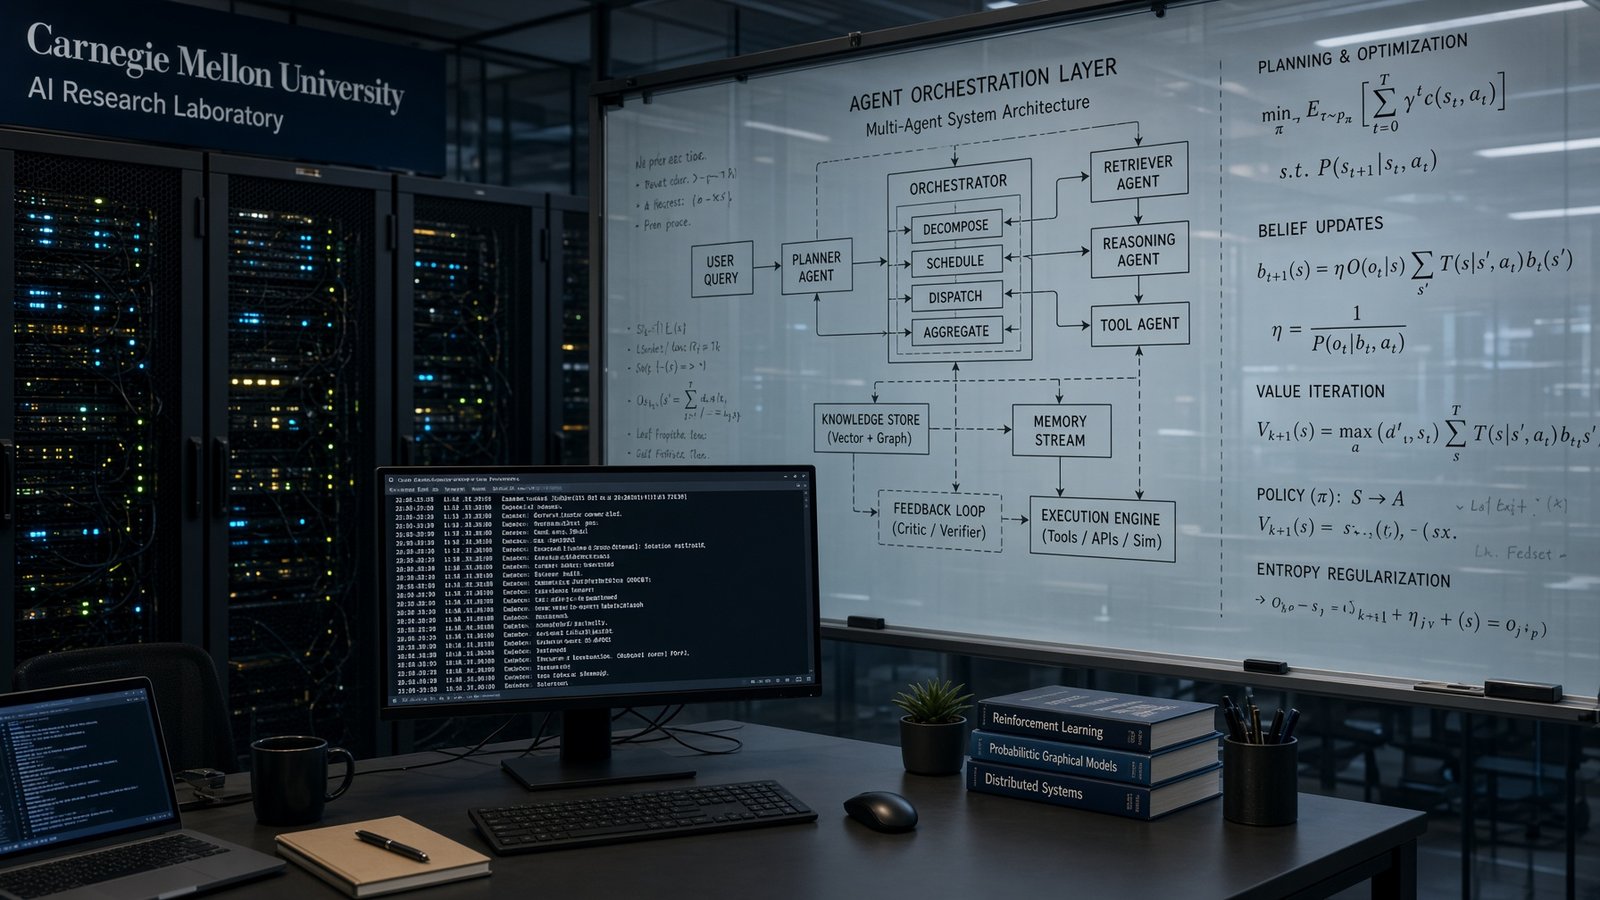
Группа учёных из Университета Карнеги — Меллон и Meta под руководством Цзяжуя Лю (Jiarui Liu) представила систему IdeaScientist, предназначенную для генерации научных гипотез и исследовательских планов. До сих пор алгоритмы класса AutoResearch выполняли одновременно все этапы: придумывали идею, писали код, ставили эксперименты и составляли текст отчёта. Разработчики выделили рождение гипотезы в самостоятельный процесс, передав задачи трём специализированным цифровым агентам.
Первый агент («поисковик пробелов») читает профильные статьи по заданной теме и выявляет методологический барьер, мешающий текущим алгоритмам решить проблему.
Второй агент («новатор») сканирует публикации из других дисциплин, находит похожие по логике механизмы и адаптирует их под новую задачу.
Третий агент («составитель отчёта») оформляет задумку в подробный технический план с математическим описанием, оценкой рисков и критериями, способными опровергнуть предложенную теорию.
Междисциплинарный перенос против шаблонного мышления
Обычные языковые модели генерируют научные предложения перебором близких публикаций из того же узкого раздела науки. В результате получаются очевидные комбинации, которые слегка изменяют параметры известных методов. В реальной истории науки прорывы чаще происходят за счёт аналогии: принцип, доказавший эффективность в одной сфере, переносится в другую.
Для проверки этой схемы авторы собрали архив Svalbard Idea Vault из 2,77 миллиона разобранных научных идей на базе портала arXiv с 1986 по 2026 год. В качестве аналогии авторы приводят организацию поиска в интернете и рекомендательных витрин онлайн-магазинов. Поисковые серверы экономят время за счёт быстрого грубого отбора документов перед точной сортировкой. Рекомендательные системы интернет-магазинов сталкиваются с той же задержкой отклика и берут ту же двухступенчатую схему: сначала отбирают сотню подходящих товаров быстрым фильтром, затем точно рассчитывают рейтинг каждого.
Заимствование принципов из внешних дисциплин увеличило показатель оригинальности гипотез внутри предметной области на 30,7% по сравнению со стандартным локальным поиском.
Проверка на неопубликованном будущем
Для проверки системы учёные заблокировали доступ к статьям, вышедшим после 1 января 2026 года. Алгоритму предоставили формулировки задач из 14 977 реальных работ, опубликованных людьми позже этой даты, без результатов проведённых экспериментов. IdeaScientist требовалось вывести решение задачи до того, как его опубликовали авторы этих статей.
Каждого агента обучили отдельно методом асинхронного обучения с подкреплением GRPO. На открытой модели Qwen3.6 с 27 миллиардами параметров система IdeaScientist превзошла сильнейший открытый аналог на 14,0% по совокупности критериев новизны и технической глубины. На той же открытой архитектуре она обошла коммерческие инструменты Claude Code SDK с моделью Claude-4.8-Opus на 5,9% и Codex SDK с моделью GPT-5.4 на 5,1%.
Методологические риски и пределы применимости
В исследовании присутствуют ограничения, заставляющие оценивать выводы с осторожностью. Проверка велась по предложенным планам экспериментов, а не по физическому запуску вычислений в лаборатории. Математически стройная гипотеза на бумаге может столкнуться с непредвиденными аппаратными сбоями или неустранимым шумом в данных.
Второе ограничение связано с обучением базовых языковых моделей. Хотя архив поиска строго ограничили датой отсечки, сами протестированные модели обучались создателями весной 2026 года. Авторы провели контрольный опрос моделей по заголовкам 10 скрытых статей и не зафиксировали прямого запоминания формулировок, однако скрытые следы методов могли сохраниться во внутренних весах нейросетей. Код проекта и база данных размещены в открытом доступе на платформах GitHub и Hugging Face для независимого воспроизведения.